检索(Retrieval)
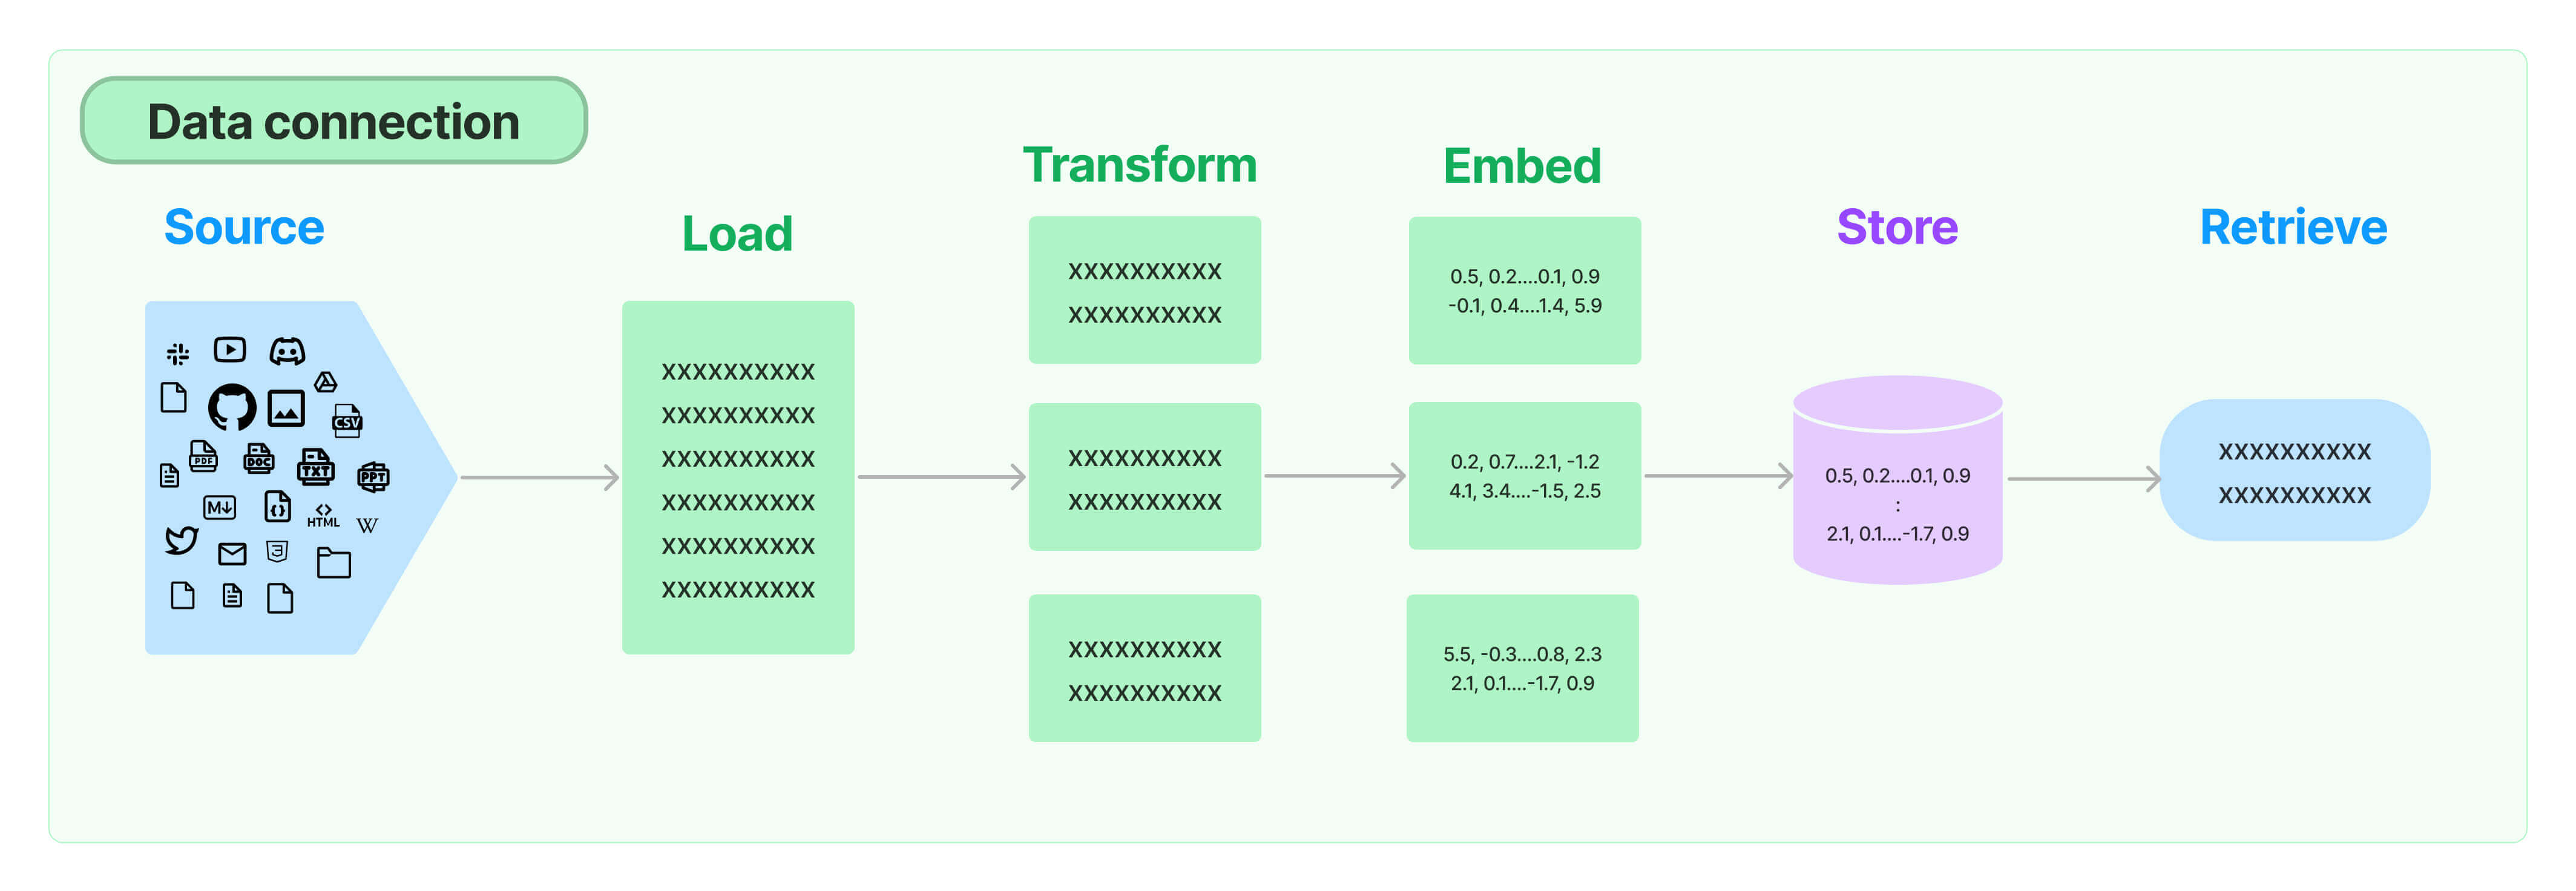
许多 LLM 应用需要用户特定的、不在模型训练集中的数据。 实现这一点的首要方式是通过检索增强生成(Retrieval Augmented Generation,RAG)。 在这个过程中,外部数据被 检索(retrieved) 出来,然后在 生成(generation) 步骤中传给 LLM。
LangChain 提供了 RAG 应用所需的所有构建模块——从简单到复杂。 文档的这一节涵盖与 检索 步骤相关的一切——例如数据的获取(fetching)。 虽然这听起来简单,但它可能相当复杂。 它涵盖几个关键模块。
文档加载器
文档加载器 从许多不同的来源加载文档。 LangChain 提供 100 多种不同的文档加载器,以及与其它主要提供方(如 AirByte 和 Unstructured)的集成。 LangChain 提供了从各种位置(私有 S3 存储桶、公共网站)加载各种类型文档(HTML、PDF、代码)的集成。
文本分割
检索的一个关键部分是只获取文档中相关的部分。 这涉及几个转换步骤,为检索准备好文档。 其中主要的一步是把大文档分割(或分块)成更小的块。 LangChain 提供了若干转换算法来完成这件事,以及针对特定文档类型(代码、markdown 等)优化的逻辑。
文本嵌入模型
检索的另一个关键部分是为文档创建嵌入。 嵌入捕捉文本的语义含义,使你能够快速且 高效地找到文本中相似的其他部分。 LangChain 提供了与 25 个以上不同嵌入提供方和方法的集成, 从开源到专有 API, 让你选择最适合自己需求的那个。 LangChain 提供标准接口,让你可以轻松地在模型之间切换。
向量存储
随着嵌入的兴起,出现了对能够高效存储和搜索这些嵌入的数据库的需求。 LangChain 提供了与 50 多个不同向量存储的集成,从开源本地存储到云托管的专有存储, 让你选择最适合自己需求的那个。 LangChain 暴露一个标准接口,让你可以轻松地在向量存储之间切换。
检索器
一旦数据进入数据库,你仍然需要检索它。 LangChain 支持许多不同的检索算法,是我们创造最大价值的领域之一。 LangChain 支持易于上手的基本方法——即简单的语义搜索。 但除此之外,我们还加入了一组算法来提升性能。 这些包括:
- 父子文档检索器:允许你为每个父文档创建多个嵌入,让你可以查找更小的块但返回更大的上下文。
- 自查询检索器:用户的问题往往包含某种引用,它不只是语义上的,而是表达某种最适合用元数据过滤器来代表的逻辑。自查询允许你从查询中的其它 元数据过滤器 中解析出查询的 语义 部分。
- 集成检索器:有时你可能想从多个不同来源检索文档,或使用多种不同算法。集成检索器让你可以轻松做到这一点。
- 以及更多!
索引
LangChain 的 Indexing API 将你的数据从任何来源同步到向量存储中, 帮助你:
- 避免将重复内容写入向量存储
- 避免重写未更改的内容
- 避免对未更改的内容重新计算嵌入
所有这些都应该为你节省时间和金钱,并改善你的向量搜索结果。