网络爬虫

用例
网络研究 (opens in a new tab) 是杀手级的 LLM 应用之一:
- 用户已将其标记为他最想要的人工智能工具之一。
- 类似于 gpt-researcher (opens in a new tab) 的 OSS 仓库越来越受欢迎。
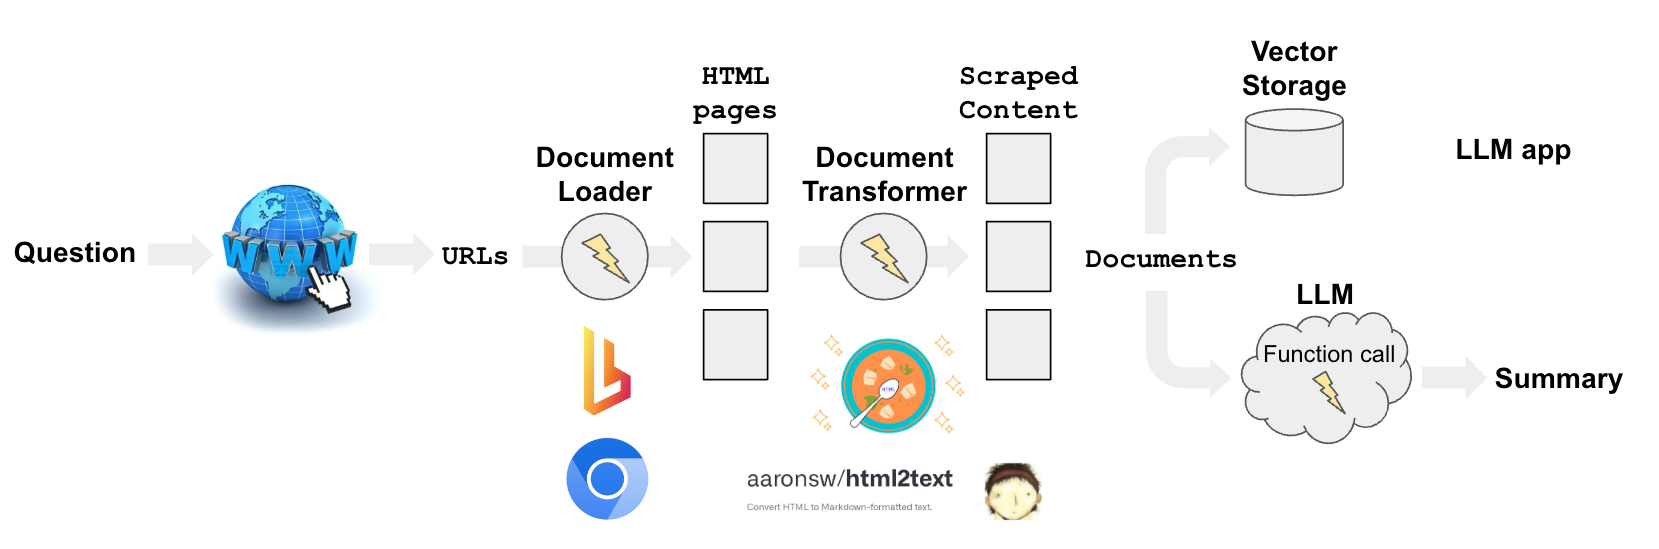
概述
从网络上获取内容有几个组成部分:
搜索:通过 url 查询(例如使用GoogleSearchAPIWrapper)。加载:将 url 加载为 HTML(例如使用AsyncHtmlLoader、AsyncChromiumLoader等)。转换:将 HTML 转换为格式化文本(例如使用HTML2Text或Beautiful Soup)。
快速入门
pip install -q langchain-openai langchain playwright beautifulsoup4
playwright安装

# 设置环境变量 OPENAI_API_KEY,或从.env 文件加载:
# import dotenv
# dotenv.load_dotenv()
使用无头 Chromium 实例进行 HTML 内容的爬取。
- 使用 Python 的 asyncio 库来处理爬取过程的异步性。
- 与网页的实际交互由 Playwright 处理。
from langchain_community.document_loaders import AsyncChromiumLoader
from langchain_community.document_transformers import BeautifulSoupTransformer

# 加载 HTML
loader = AsyncChromiumLoader(["https://www.wsj.com"])
html = loader.load()
从 HTML 内容中提取文本内容标签,例如 <p>、<li>、<div>和<a> 标签:
-
<p>:段落标签。它在 HTML 中定义一个段落,用于分组相关的句子和/或短语。 -
<li>:列表项标签。它在有序(<ol>)和无序(<ul>)列表中定义列表中的单个项。 -
<div>:分隔符标签。它是一个块级元素,用于分组其他内联或块级元素。 -
<a>:锚标签。它用于定义超链接。 -
<span>:内联容器,用于标记一个文本部分或文档的一部分。
对于许多新闻网站(例如 WSJ、CNN),标题和摘要都放在 <span> 标签中。
# 转换
bs_transformer = BeautifulSoupTransformer()
docs_transformed = bs_transformer.transform_documents(html, tags_to_extract=["span"])
# 结果
docs_transformed[0].page_content[0:500]这些 Documents 现在被用于各种 LLM 应用的下游使用,如下所述。
Loader
AsyncHtmlLoader
AsyncHtmlLoader (opens in a new tab) 使用 aiohttp 库进行异步 HTTP 请求,适用于简单和轻量级的爬取。
AsyncChromiumLoader
AsyncChromiumLoader (opens in a new tab) 使用 Playwright 启动 Chromium 实例,可以处理 JavaScript 渲染和更复杂的网页交互。
Chromium 是 Playwright 支持的浏览器之一,Playwright 是一个用于控制浏览器自动化的库。
无头模式意味着浏览器在没有图形用户界面的情况下运行,通常用于网络爬虫。
from langchain_community.document_loaders import AsyncHtmlLoader

urls = ["https://www.espn.com", "https://lilianweng.github.io/posts/2023-06-23-agent/"]
loader = AsyncHtmlLoader(urls)
docs = loader.load()
Transformer
HTML2Text
HTML2Text (opens in a new tab) 将 HTML 内容直接转换为普通文本(带有类似 Markdown 的格式),不进行任何特定的标签操作。
它最适用于提取可阅读的文本而无需操纵特定的 HTML 元素的情况。
Beautiful Soup
Beautiful Soup 提供对 HTML 内容更精细的控制,可以提取、删除和清理特定标签。
它适用于您想提取特定信息并根据需要清理 HTML 内容的情况。
from langchain_community.document_loaders import AsyncHtmlLoader

urls = ["https://www.espn.com", "https://lilianweng.github.io/posts/2023-06-23-agent/"]
loader = AsyncHtmlLoader(urls)
docs = loader.load()
正在获取页面:100%|#############################################################################################################| 2/2 [00:00 < 00:00, 7.01it/s]from langchain_community.document_transformers import Html2TextTransformer
html2text = Html2TextTransformer()
docs_transformed = html2text.transform_documents(docs)
docs_transformed[0].page_content[0:500]" Skip to main content Skip to navigation\n\n <\n\n>\n\nMenu\n\n## ESPN\n\n * Search\n\n * * scores\n\n * NFL\n\n * MLB\n\n * NBA\n\n * NHL\n\n * Soccer\n\n * NCAAF\n\n * …\n\n * Women's World Cup\n\n * LLWS\n\n * NCAAM\n\n * NCAAW\n\n * Sports Betting\n\n * Boxing\n\n * CFL\n\n * NCAA\n\n * Cricket\n\n * F1\n\n * Golf\n\n * Horse\n\n * MMA\n\n * NASCAR\n\n * NBA G League\n\n * Olympic Sports\n\n * PLL\n\n * Racing\n\n * RN BB\n\n * RN FB\n\n * Rugby\n\n * Tennis\n\n * WNBA\n\n * WWE\n\n * X Games\n\n * XFL\n\n * More "带提取的爬取
使用 LLM 函数
网络爬虫存在许多挑战。
其中之一是现代网站布局和内容的变化性,需要修改爬取脚本以适应这些变化。
使用函数(例如 OpenAI)与提取链,可以避免在网站更改时不断改变代码。
我们使用 gpt-3.5-turbo-0613 来保证访问 OpenAI Functions 功能(尽管在撰写本文时可能对所有人都可用)。
我们还将 temperature 设置为 0,以降低 LLM 生成文本的随机性。
from langchain_openai import ChatOpenAI

llm = ChatOpenAI(temperature=0, model="gpt-3.5-turbo-0613")
定义一个模式
接下来,您需要定义一个模式来指定要提取的数据类型。
在这里,键名很重要,因为它们告诉 LLM 您想要的信息类型。
因此,请尽可能详细。
在此示例中,我们只想从《华尔街日报》网站上提取新闻文章的名称和摘要。
from langchain.chains import create_extraction_chain

schema = {
    "properties": {
        "news_article_title": {"type": "string"},
        "news_article_summary": {"type": "string"},
    },
    "required": ["news_article_title", "news_article_summary"],
}


def extract(content: str, schema: dict):
    return create_extraction_chain(schema=schema, llm=llm).run(content)
运行网页爬虫(使用 BeautifulSoup)
如上所示,我们将使用 BeautifulSoupTransformer。
import pprint

from langchain_text_splitters import RecursiveCharacterTextSplitter


def scrape_with_playwright(urls, schema):
    loader = AsyncChromiumLoader(urls)
    docs = loader.load()
    bs_transformer = BeautifulSoupTransformer()
    docs_transformed = bs_transformer.transform_documents(
        docs, tags_to_extract=["span"]
    )
    print("使用LLM提取内容")
# 抓取网站的前 1000 个标记
splitter = RecursiveCharacterTextSplitter.from_tiktoken_encoder(
    chunk_size = 1000, chunk_overlap = 0
)
splits = splitter.split_documents(docs_transformed)

# 处理第一个分割部分
extracted_content = extract(schema = schema, content = splits [0].page_content)
pprint.pprint(extracted_content)
return extracted_content


urls = ["https://www.wsj.com"]
extracted_content = scrape_with_playwright(urls, schema = schema)
提取使用 LLM 的内容
[{'news_article_summary': '美国人将继续被软禁,直到几周后才被允许返回美国,这是拜登政府经过几个月的外交努力后的结果。',
'news_article_title': '四名美国人被释放出伊朗监狱'},
{'news_article_summary': '上个月,价格压力继续下降,CPI 从 6 月上升了 0.2%,这可能使美联储在 9 月会议上不会加息。',
'news_article_title': '更凉爽的 7 月通胀为联邦储备留出加息空间'},
{'news_article_summary': '该公司决定淘汰其 30 个服装品牌中的 27 个,例如 Lark & Ro 和 Goodthreads,以应对反垄断审查和削减成本。',
'news_article_title': '亚马逊删除数十个自有品牌'},
{'news_article_summary': '拜登总统的命令加剧了中美两国之间放缓的经济、新冠封锁和不断增长的紧张关系。',
'news_article_title': '美国对中国的投资禁令有望加深分歧'},
{'news_article_summary': '选举干预案的拟议审判日期与前总统对额外 Mar-a-Lago 指控的无罪辩诉是同一天。',
'news_article_title': '检方告诉法官,特朗普应在 1 月受审'},
{'news_article_summary': '6 月就职的 CEO 表示,该平台对未来有“完全不同的路线图”。',
'news_article_title': '雅卡里诺(Yaccarino)表示,X 在观察帖子,但有自己的愿景'},
{'news_article_summary': '学生为旗舰州立大学埋单,这些大学在新建筑物和项目上投入了大量资金,几乎没有任何阻力。',
'news_article_title': '大学“疯狂”消费,“这些地方在疯狂地消耗金钱”'},
{'news_article_summary': '由飓风风吹大火席卷了夏威夷岛的部分地区,毁灭了人气旅游城镇拉海纳。',
'news_article_title': '梅县野火造成至少 36 人死亡'},
{'news_article_summary': '在其大型装甲推进遇阻之后,基辅已经开始采用早期在战争中获得成功的战术。',
'news_article_title': '乌克兰使用小组战术夺回被占领的领土'},
{'news_article_summary': '瓜亚基尔宣布进入紧急状态,总统拉索表示,8 月 20 日的选举将继续进行,这个安第斯国家正在应对日益增加的毒品团伙暴力。',
'news_article_title': '厄瓜多尔总统候选人遇害后宣布进入紧急状态'},
{'news_article_summary': '气候科学家表示,由于今年的飓风季节通常从 6 月持续到 11 月底,所以很难预测今年的飓风季节。',
'news_article_title': '美国国家海洋和大气管理局表示,大西洋飓风季节预测增加到“高于正常水平”'},
{'news_article_summary': '美国橄榄球联盟将提高 NFL+流媒体包的价格,并添加 NFL Network 和 RedZone。',
'news_article_title': '随着增加 NFL Network 和 RedZone,NFL 将提高 NFL+流媒体包的价格'},
{'news_article_summary': '俄罗斯计划进行一次月球任务,这是新的太空竞赛的一部分。',
'news_article_title': '俄罗斯的月球任务和新的太空竞赛'},
{'news_article_summary': 'Tapestry 以 85 亿美元收购 Capri 将创建一个年销售额超过 120 亿美元的企业集团,但仍然缺乏推动 LVMH 成功的高动能品牌和多样性。',
'news_article_title': '为什么 Coach 和 Kors 的合并不让 LVMH 感到恐慌'},
{'news_article_summary': '最高法院阻止了 Purdue Pharma 的 60 亿美元 Sackler 解决方案。',
'news_article_title': '最高法院阻止 Purdue Pharma 的 60 亿美元 Sackler 阿片类解决方案'},
{'news_article_summary': '预计 2024 年社会保障 COLA 将上升,但不会增加太多。',
'news_article_title': '社会保障 COLA 预计将在 2024 年上升,但不会增加太多'}]我们可以将提取的标题与页面上的标题进行对比:
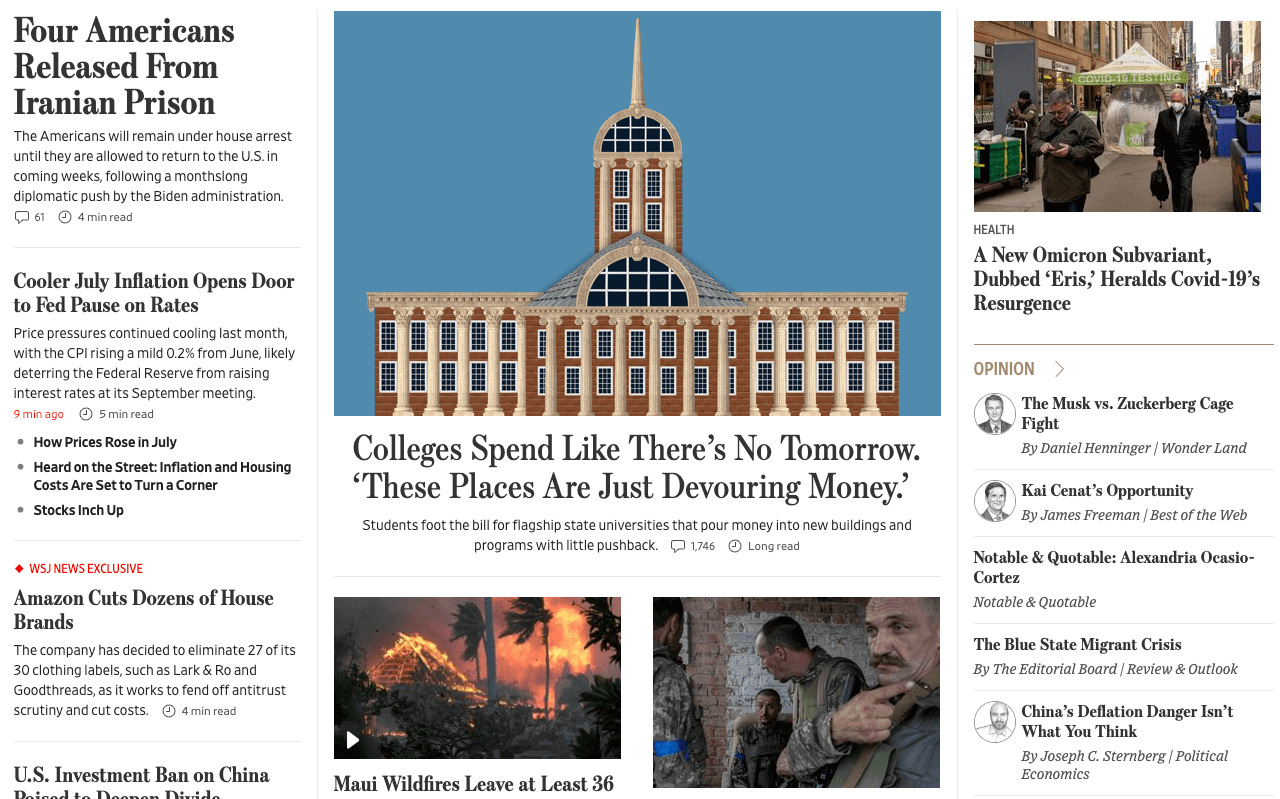
通过查看LangSmith追踪 (opens in a new tab),我们可以看到底层的操作:
- 它遵循了extraction中的解释。
- 我们在输入文本上调用了
information_extraction函数。 - 它将尝试从url内容中填充提供的模式。
研究自动化
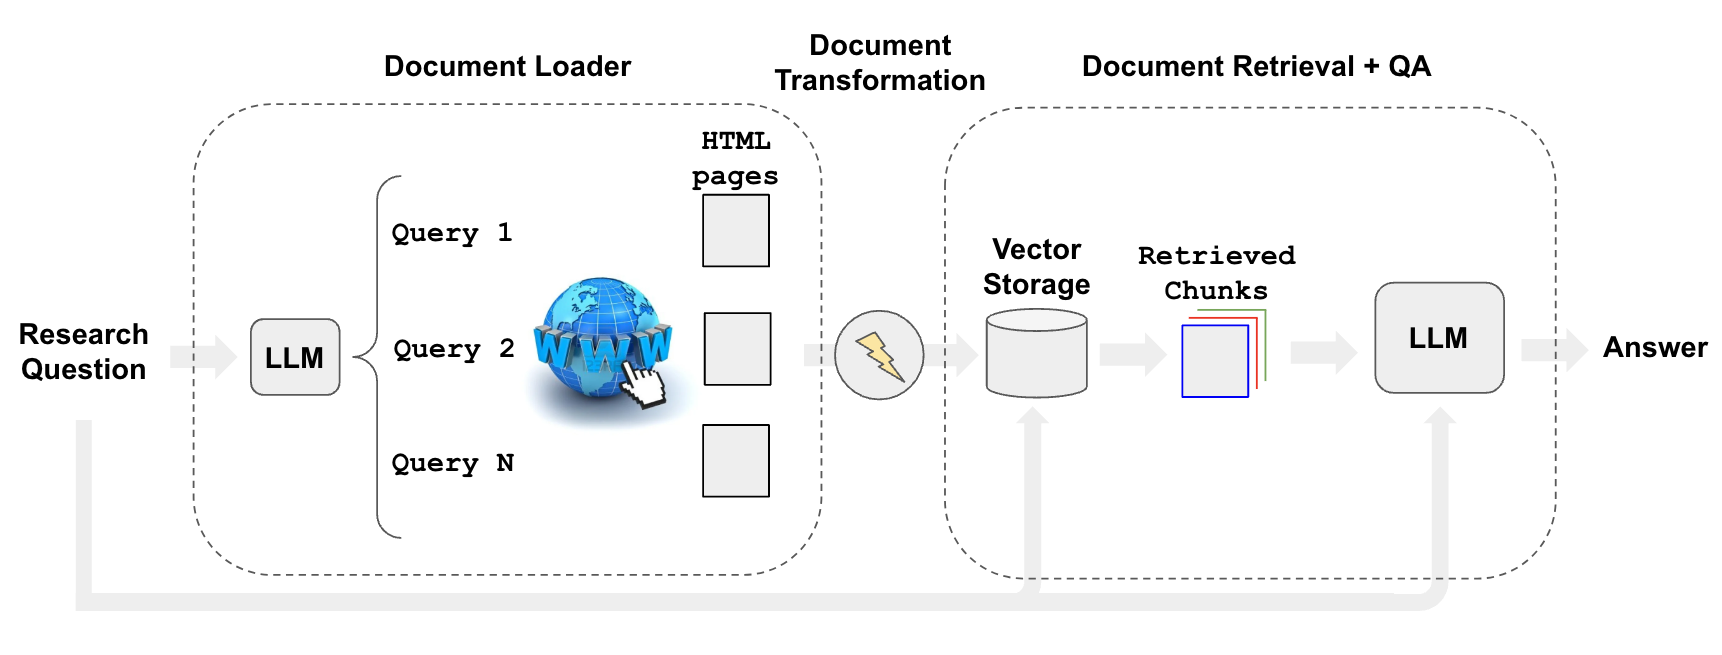
与抓取相关的情况下,我们可能想要使用搜索内容来回答特定的问题。
我们可以使用检索器,例如WebResearchRetriever来自动化网络研究 (opens in a new tab)的过程。
从这里 (opens in a new tab)复制需求:
pip install -r requirements.txt
设置GOOGLE_CSE_ID和GOOGLE_API_KEY。
from langchain.retrievers.web_research import WebResearchRetriever
from langchain_community.utilities import GoogleSearchAPIWrapper
from langchain_chroma import Chroma
from langchain_openai import ChatOpenAI, OpenAIEmbeddings
# 设置矢量库
vectorstore = Chroma(
embedding_function = OpenAIEmbeddings(), persist_directory = "./chroma_db_oai"
)
# 设置 LLM
llm = ChatOpenAI(temperature = 0)
# 设置搜索器
search = GoogleSearchAPIWrapper()使用上述工具初始化检索器:
- 使用LLM生成多个相关的搜索查询(一个LLM调用)
- 对每个查询执行搜索
- 选择每个查询的前K个链接(并行执行多个搜索调用)
- 加载所有选择的链接的信息(并行抓取页面)
- 将这些文档索引到矢量库中
- 找到每个原始生成的搜索查询最相关的文档
# 初始化
web_research_retriever = WebResearchRetriever.from_llm(
    vectorstore = vectorstore, llm = llm, search = search
)
# 运行
import logging
logging.basicConfig()
logging.getLogger("langchain.retrievers.web_research").setLevel(logging.INFO)
from langchain.chains import RetrievalQAWithSourcesChain
user_input = "How do LLM Powered Autonomous Agents work?"
qa_chain = RetrievalQAWithSourcesChain.from_chain_type(
llm, retriever = web_research_retriever
)
result = qa_chain({"question": user_input})
resultINFO:langchain.retrievers.web_research:生成Google搜索问题...
INFO:langchain.retrievers.web_research:Google搜索问题(原始):{'question': 'How do LLM Powered Autonomous Agents work?', 'text': LineList(lines=['1. What is the functioning principle of LLM Powered Autonomous Agents?\n', '2. How do LLM Powered Autonomous Agents operate?\n'])}
INFO:langchain.retrievers.web_research:Google搜索问题:['1. What is the functioning principle of LLM Powered Autonomous Agents?\n', '2. How do LLM Powered Autonomous Agents operate?\n']
INFO:langchain.retrievers.web_research:正在搜索相关的网址 ...
INFO:langchain.retrievers.web_research:正在搜索相关的网址 ...
INFO:langchain.retrievers.web_research:搜索结果:{'title': 'LLM Powered Autonomous Agents | Hacker News', 'link': 'https://news.ycombinator.com/item?id=36488871', 'snippet': 'Jun 26, 2023 ... Exactly. A temperature of 0 means you always pick the highest probability token (i.e. the "max" function), while a temperature of 1 means you\xa0...'}
INFO:langchain.retrievers.web_research:正在搜索相关的网址 ...
INFO:langchain.retrievers.web_research:搜索结果:{'title': "LLM Powered Autonomous Agents | Lil'Log", 'link': 'https://lilianweng.github.io/posts/2023-06-23-agent/', 'snippet': 'Jun 23, 2023 ... Task decomposition can be done (1) by LLM with simple prompting like "Steps for XYZ.\\n1." , "What are the subgoals for achieving XYZ?" , (2) by\xa0...'}
INFO:langchain.retrievers.web_research:新的要加载的URL:[]
INFO:langchain.retrievers.web_research:正在从URL中获取最相关的split...
{'question': 'How do LLM Powered Autonomous Agents work?',
'answer': 'LLM-powered autonomous agents work by using LLM as the agent\'s brain, complemented by several key components such as planning, memory, and tool use. In terms of planning, the agent breaks down large tasks into smaller subgoals and can ...
深入探索
- 这里有一个应用 (opens in a new tab),将该检索器封装在一个轻量级 UI 中。
基于网站进行问答
要针对特定网站进行问答,你可以使用 Apify 的 Website Content Crawler (opens in a new tab) Actor,它可以深度爬取文档、知识库、帮助中心或博客等网站,并从网页中提取文本内容。
在下面的示例中,我们将深度爬取 LangChain 的 Chat LLM 模型文档,并针对它回答一个问题。
首先,安装依赖
pip install apify-client langchain-openai langchain
然后,在环境变量中设置 OPENAI_API_KEY 和 APIFY_API_TOKEN。
完整代码如下:
from langchain.indexes import VectorstoreIndexCreator
from langchain_community.docstore.document import Document
from langchain_community.utilities import ApifyWrapper

apify = ApifyWrapper()
# 调用 Actor 从爬取的网页获取文本
loader = apify.call_actor(
    actor_id = "apify/website-content-crawler",
    run_input ={"startUrls": [{"url": "/docs/integrations/chat/"}]},
    dataset_mapping_function = lambda item: Document(
        page_content = item ["text"] or "", metadata ={"source": item ["url"]}
    ),
)

# 基于爬取的数据创建向量存储
index = VectorstoreIndexCreator().from_loaders([loader])

# 查询向量存储
query = "是否有集成 LangChain 的 OpenAI 聊天模型?"
result = index.query(query)
print(result)
是的,LangChain 提供与 OpenAI 聊天模型的集成。您可以使用 ChatOpenAI 类与 OpenAI 模型进行交互。