使用 RAG 进行问答
概述
LLM 所能实现的最强大的应用之一是复杂的问答(Q&A)聊天机器人。这类应用可以回答关于特定源信息的问题。这些应用使用一种称为检索增强生成(Retrieval Augmented Generation,RAG)的技术。
什么是 RAG?
RAG 是一种用额外数据增强 LLM 知识的技术。
LLM 可以推理广泛的主题,但它们所知仅限于训练时所依据的、截至某个特定时间点的公开数据。如果你想构建能够推理私有数据或模型截止日期之后引入的数据的 AI 应用,你需要用模型所需的具体信息来增强它的知识。将适当的信息取回并插入模型提示的过程称为检索增强生成(RAG)。
LangChain 有许多组件旨在帮助构建问答应用,以及更广泛的 RAG 应用。
注意:这里我们重点介绍非结构化数据的问答。我们在其他地方涵盖的两个 RAG 用例是:
- 基于 SQL 数据的问答
- 基于代码的问答(例如 Python)
RAG 架构
一个典型的 RAG 应用有两个主要组件:
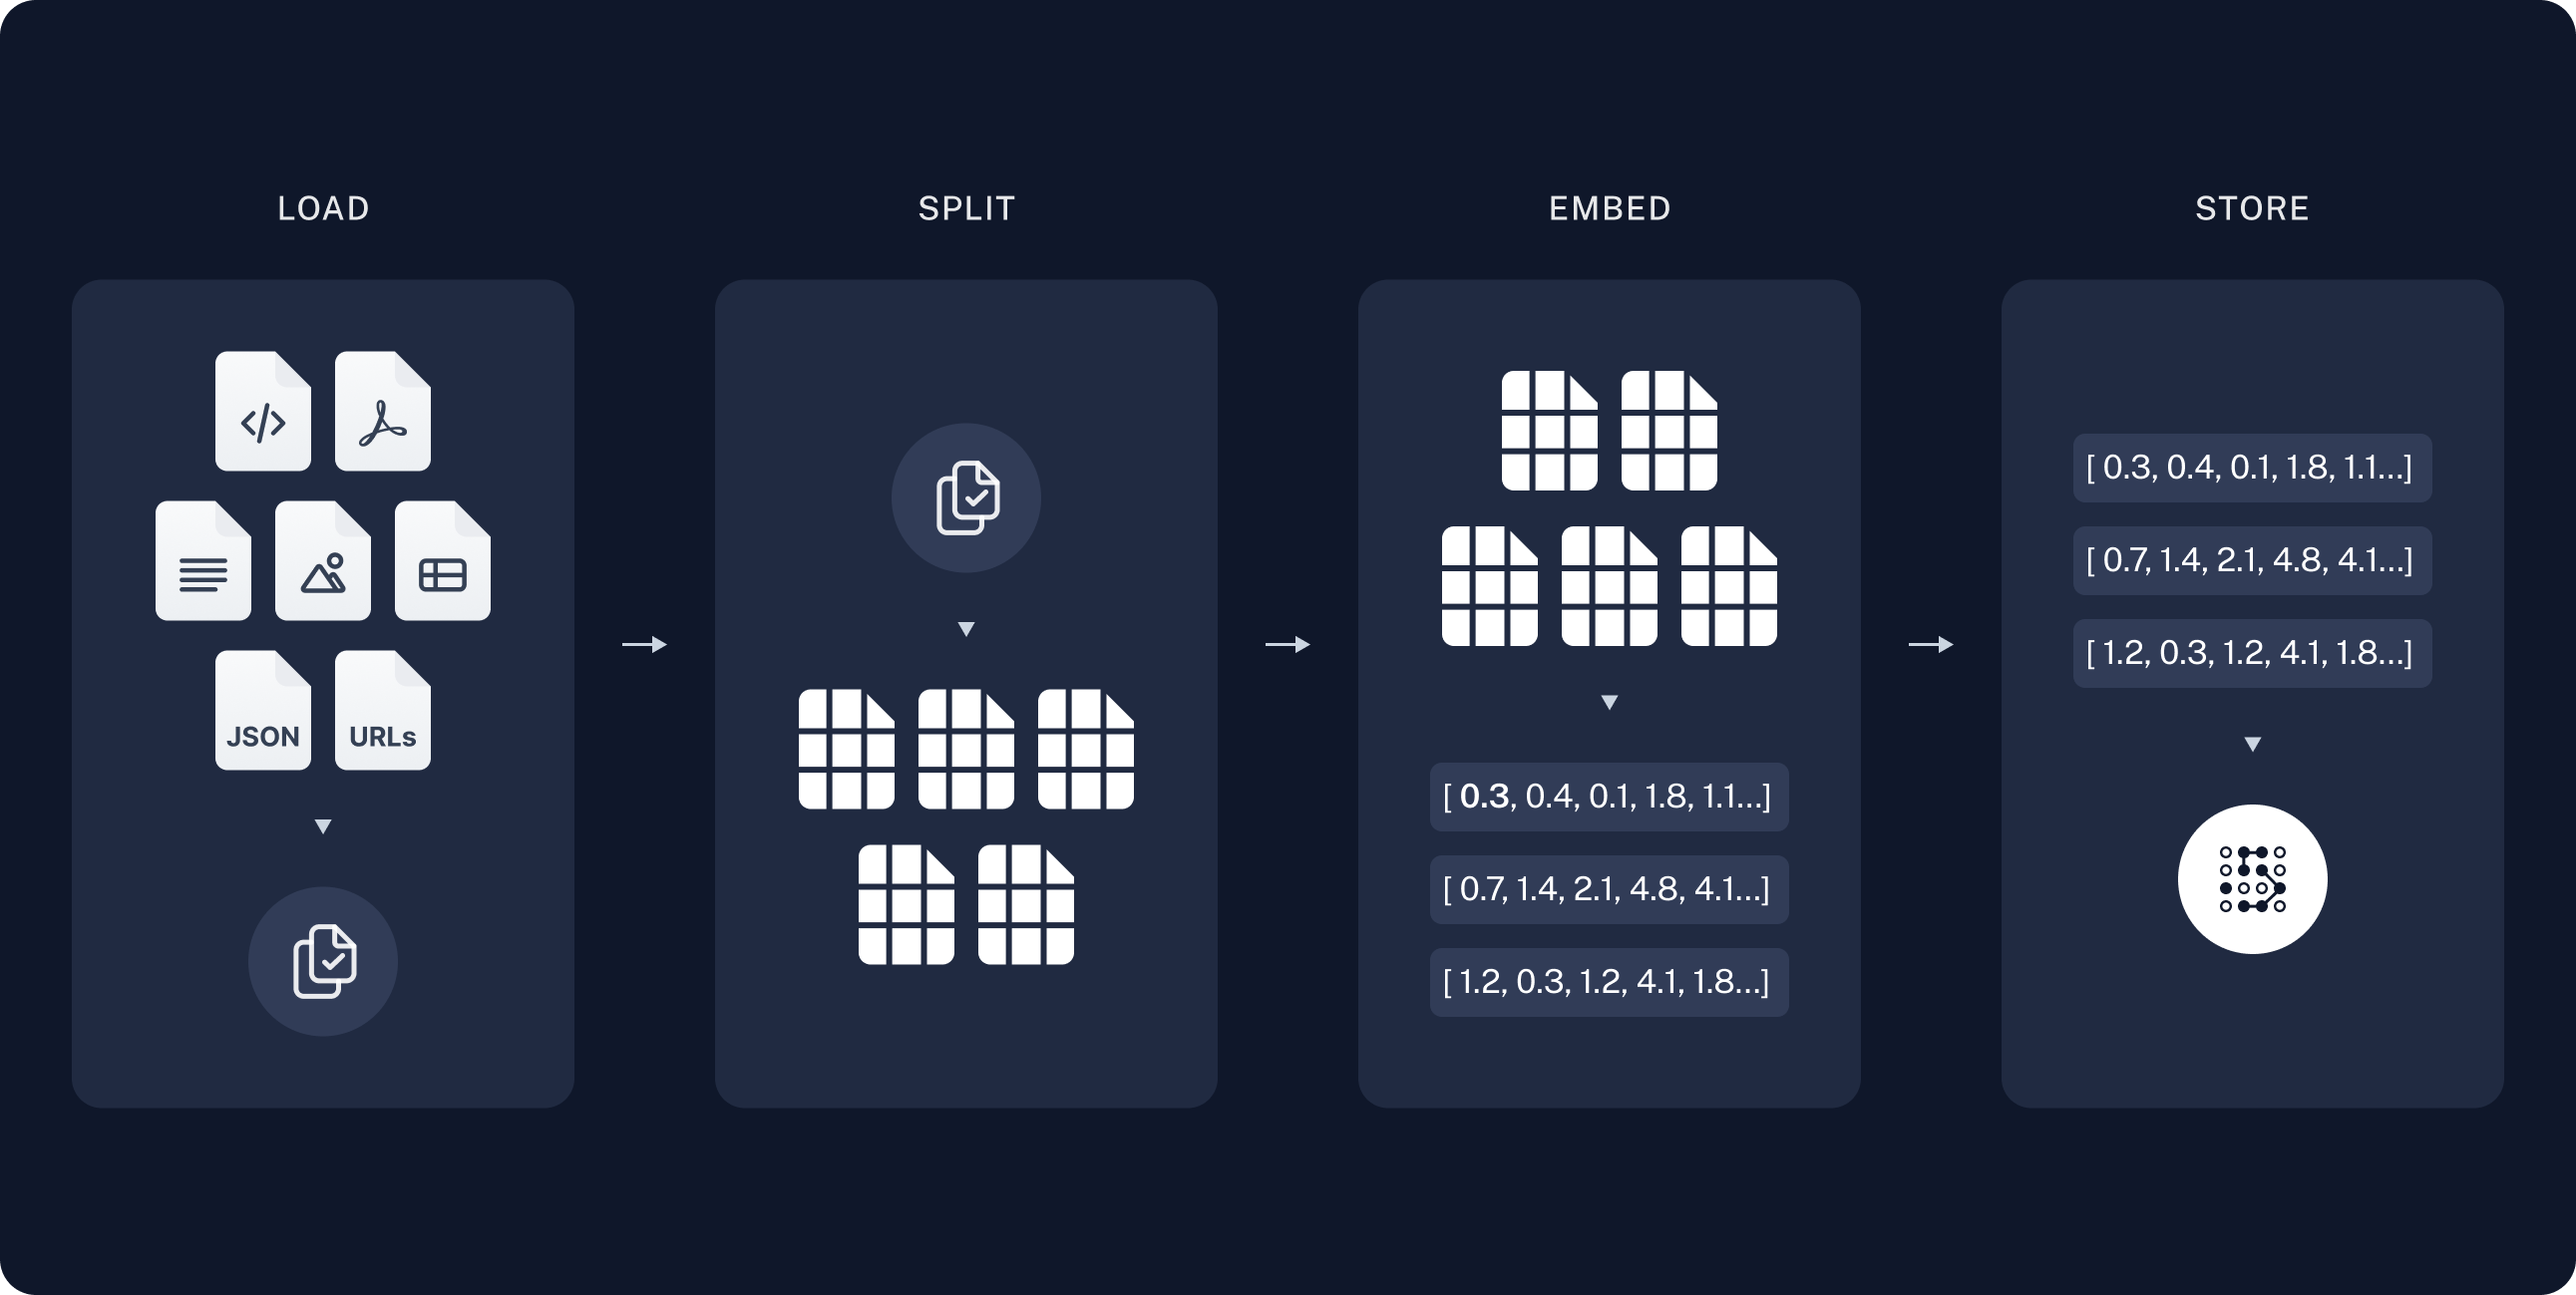
索引(Indexing):从源摄取数据并对其建立索引的流水线。这通常离线进行。
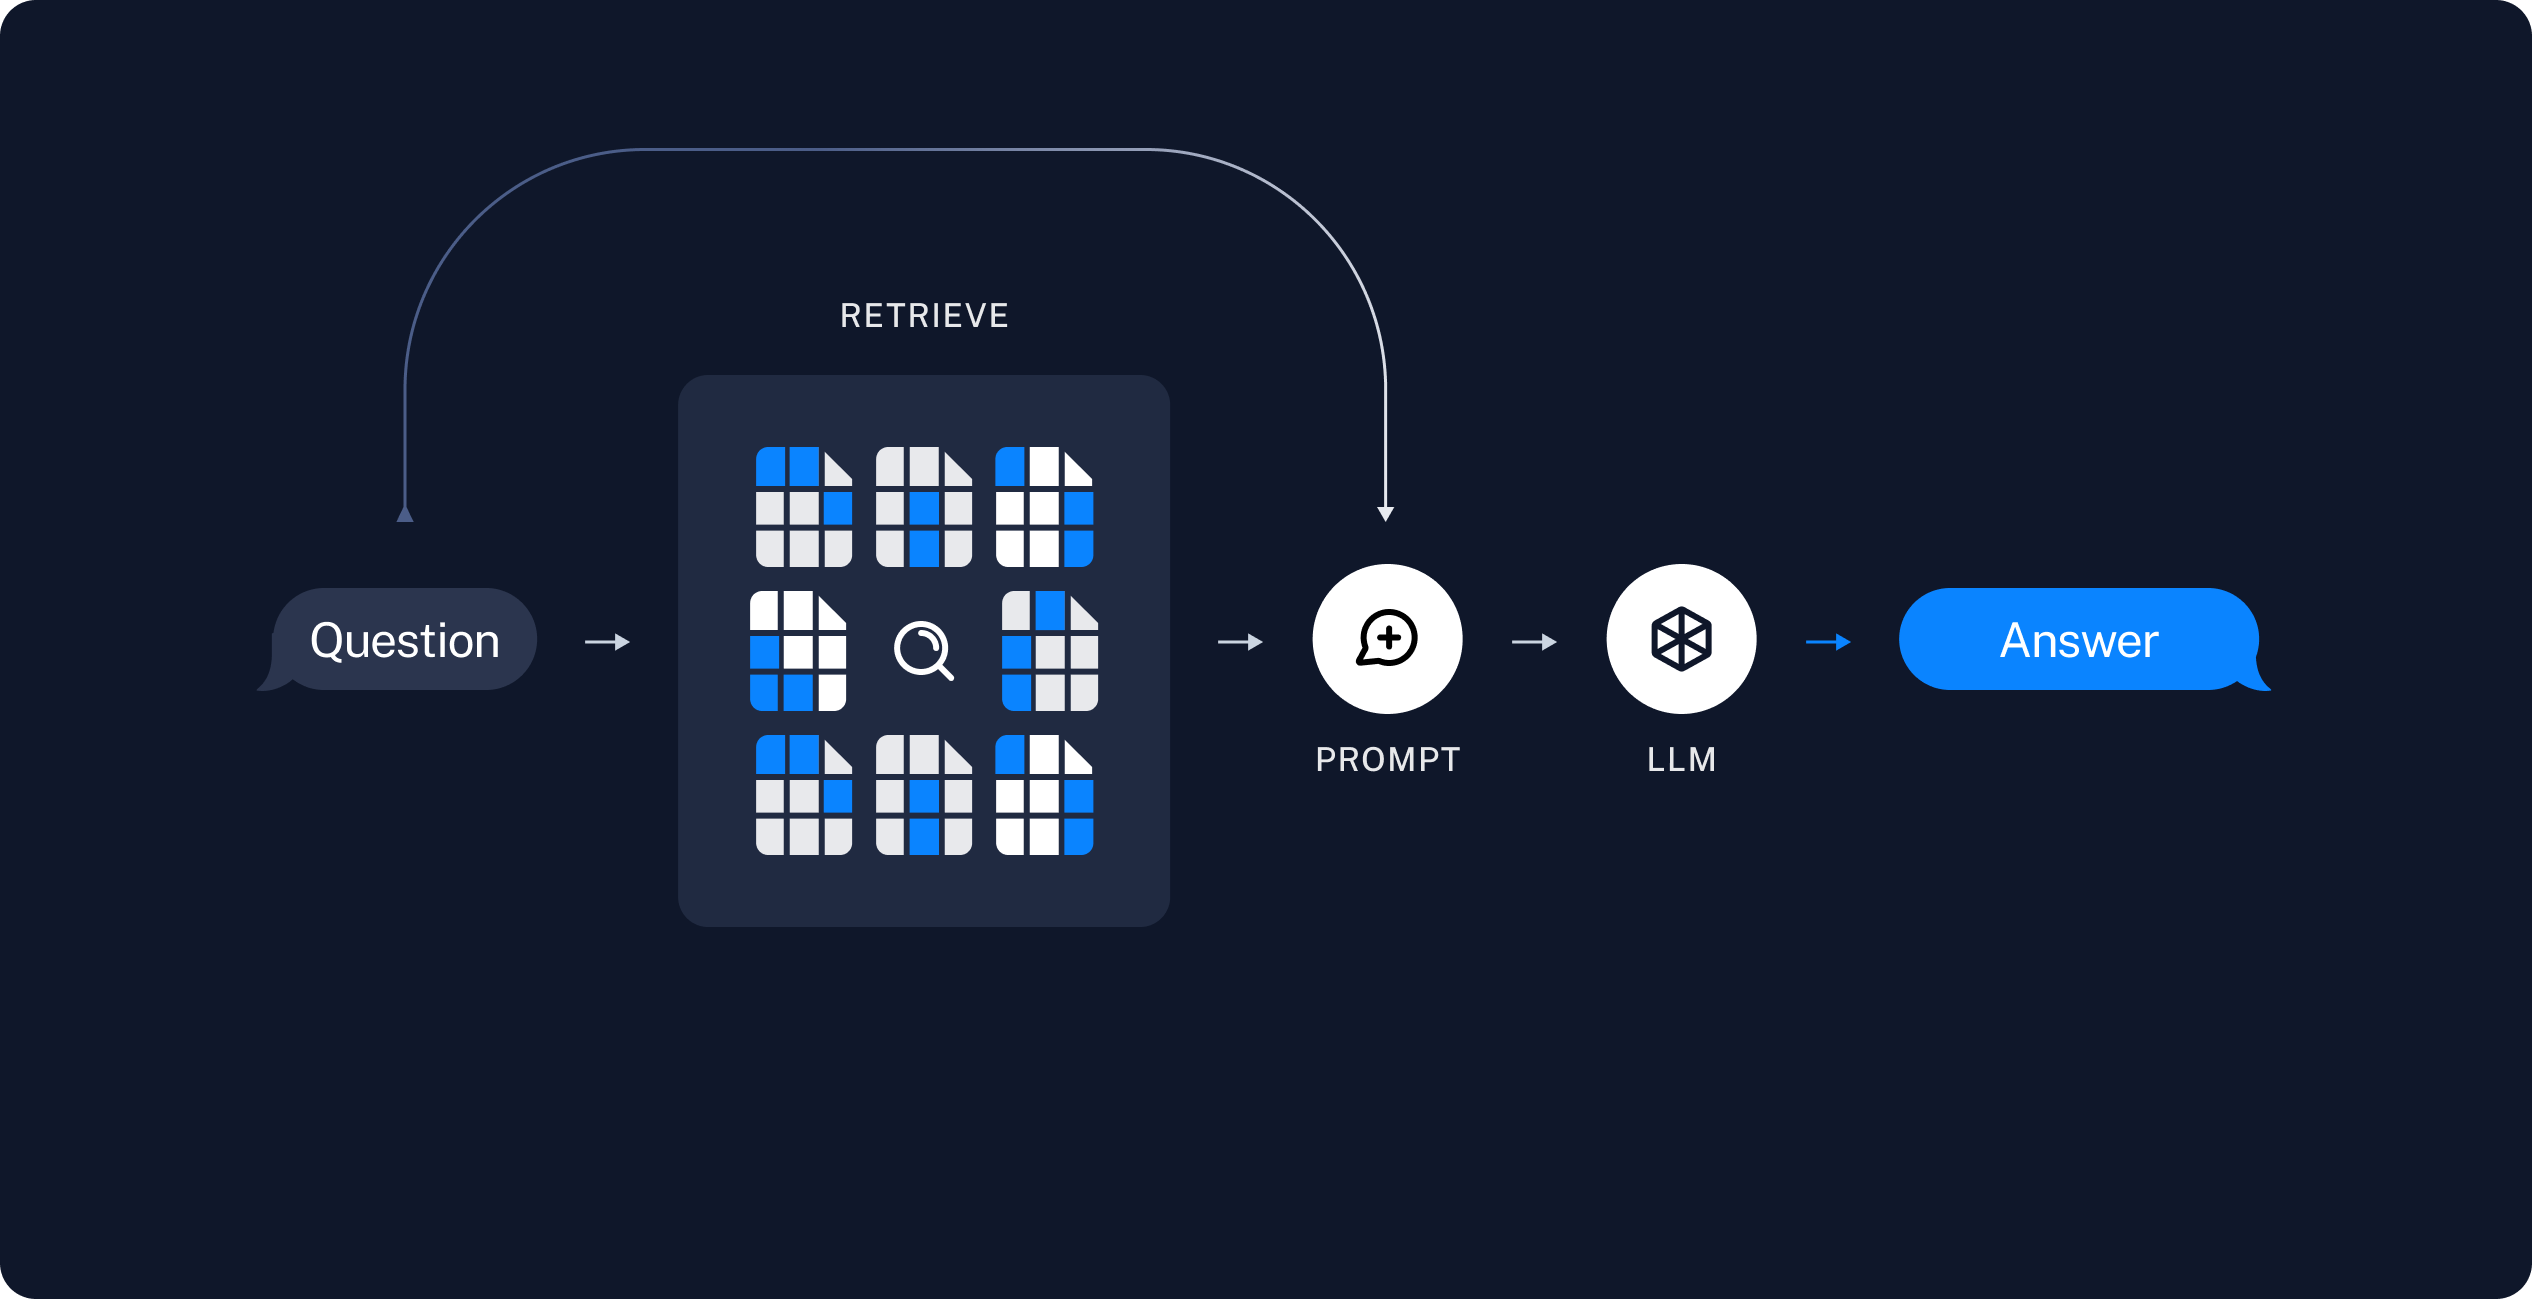
检索与生成(Retrieval and generation):实际的 RAG 链,它在运行时接收用户查询,从索引中检索相关数据,然后将其传递给模型。
从原始数据到答案最常见的一整套流程如下:
索引
- 加载(Load):首先我们需要加载数据。这通过 文档加载器 完成。
- 拆分(Split):文本拆分器 将大型
Document拆分为较小的块。这对于建立索引和将数据传入模型都很有用,因为大块更难搜索,并且无法放入模型有限的上下文窗口。 - 存储(Store):我们需要一个地方来存储和索引我们的拆分,以便之后可以对其搜索。这通常使用 向量存储 和 嵌入 模型来完成。
检索与生成