摘要

使用案例
假设您有一组文档(PDF、Notion 页面、客户问题等),您想要对内容进行摘要。
由于 LLM 在理解和综合文本方面的熟练程度,它们是进行文档摘要的很好工具。
在本教程中,我们将介绍如何使用 LLM 执行文档摘要。
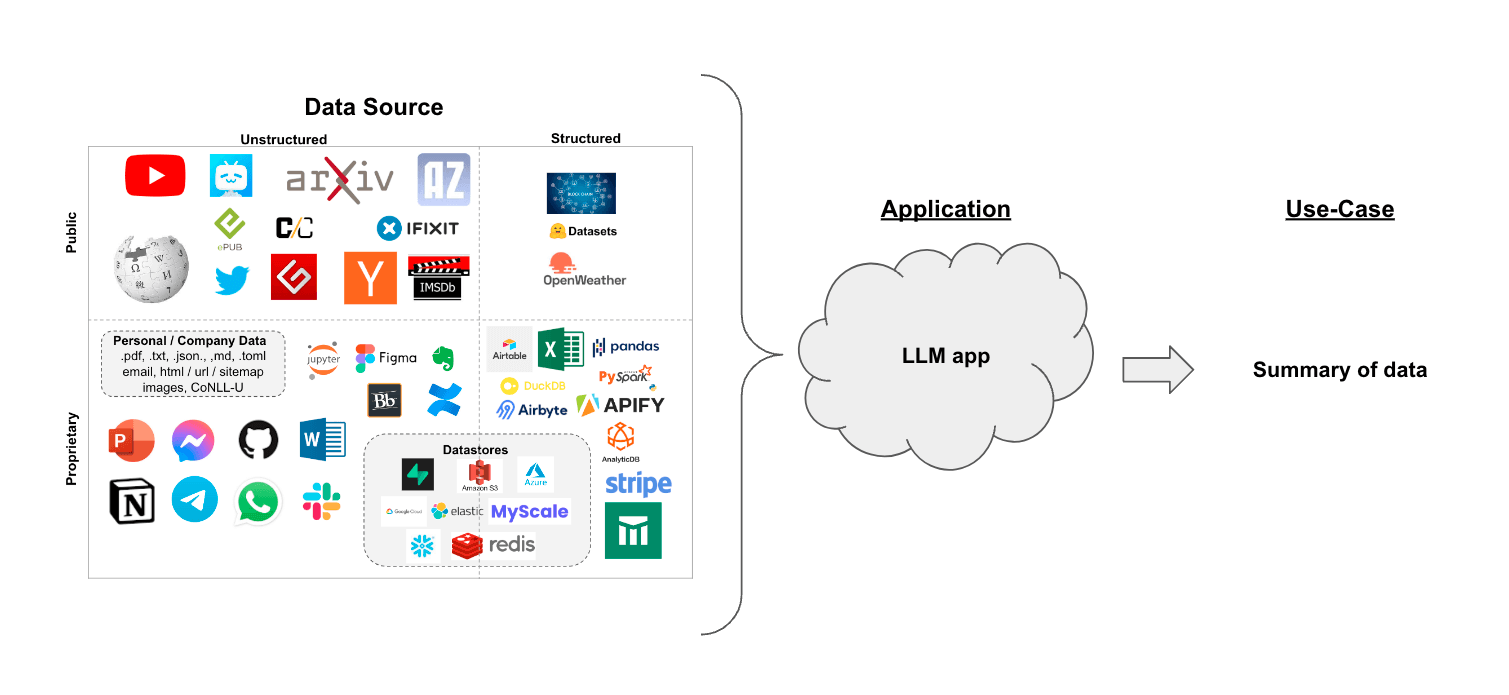
概述
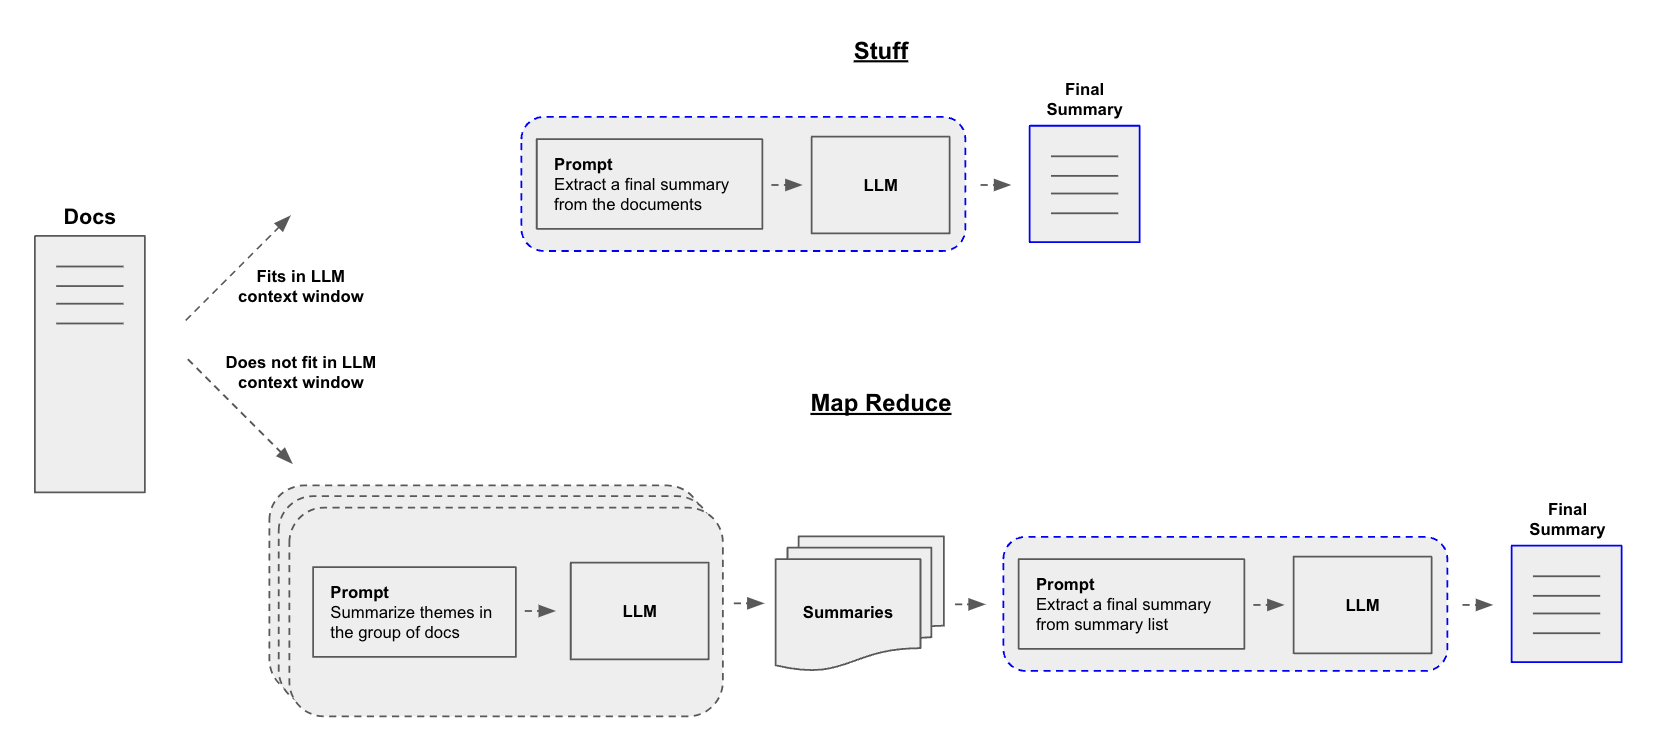
构建摘要器的一个核心问题是如何将文档传递到 LLM 的上下文窗口中。对于这个问题,有两种常见的方法:
-
"Stuff":只需将所有文档 " stuff" 进一个单独的提示中。这是最简单的方法(有关使用此方法的 "create_stuff_documents_chain" 构造函数的更多信息,请参见 此处)。
-
"Map-reduce":在 "map" 步骤中将每个文档单独摘要,然后将摘要 "reduce" 成一个最终摘要(有关使用此方法的 "MapReduceDocumentsChain" 的更多信息,请参见 此处)。
快速开始
为了给您一个 sneak preview,任何一个 pipeline 都可以包装在一个单独的对象中:load_summarize_chain。
假设我们想要对一篇博客文章进行摘要。我们可以用几行代码完成这个操作。
首先设置环境变量并安装包:
%pip install --upgrade --quiet  langchain-openai tiktoken chromadb langchain

# 设置环境变量 OPENAI_API_KEY 或从 .env 文件加载
# import dotenv

# dotenv.load_dotenv()
已经安装的“openai”要求:1.2.0
已经安装的“tiktoken”要求:0.3.3
已经安装的“chromadb”要求:0.3.7
已经安装的“langchain”要求:0.0.13
已经安装的“requests”要求:2.26.0
已经安装的“aiohttp”要求:3.7.4.post0我们可以使用 chain_type="stuff",特别是当使用较大的上下文窗口模型时,比如:
- 16k 令牌的 OpenAI
gpt-3.5-turbo-1106 - 100k 令牌的 Anthropic Claude-2 (opens in a new tab)
我们还可以提供 chain_type="map_reduce" 或 chain_type="refine"。
from langchain.chains.summarize import load_summarize_chain
from langchain_community.document_loaders import WebBaseLoader
from langchain_openai import ChatOpenAI

loader = WebBaseLoader("https://lilianweng.github.io/posts/2023-06-23-agent/")
docs = loader.load()

llm = ChatOpenAI(temperature=0, model_name="gpt-3.5-turbo-1106")
chain = load_summarize_chain(llm, chain_type="stuff")

chain.run(docs)
'文章讨论了建立由大型语言模型(LLM)驱动的自主代理的概念。它探讨了这类代理的组成部分,包括计划、内存和工具使用。该文章提供了 LLM 驱动代理在不同领域的案例研究和概念验证示例。它还强调了在代理系统中使用 LLM 的挑战和限制。'选项 1. 整体方式
当我们使用 load_summarize_chain 和 chain_type="stuff" 时,我们将使用 StuffDocumentsChain (opens in a new tab)。
该链将采用一个文档列表,将它们全部插入到一个提示中,并将该提示传递给一个 LLM:
from langchain.chains.combine_documents.stuff import StuffDocumentsChain
from langchain.chains.llm import LLMChain
from langchain_core.prompts import PromptTemplate

# 定义提示
prompt_template = """写下以下内容的简洁总结:
"{text}"
简洁总结:"""
prompt = PromptTemplate.from_template(prompt_template)

# 定义 LLM 链
llm = ChatOpenAI(temperature=0, model_name="gpt-3.5-turbo-16k")
llm_chain = LLMChain(llm=llm, prompt=prompt)

# 定义 StuffDocumentsChain
stuff_chain = StuffDocumentsChain(llm_chain=llm_chain, document_variable_name="text")

docs = loader.load()
print(stuff_chain.run(docs))
文章讨论了建立由大型语言模型(LLM)驱动的自主代理的概念。它探讨了这类代理的组成部分,包括计划、内存和工具使用。该文章提供了 LLM 驱动代理在不同领域的案例研究和概念验证示例,如科学发现和生成式代理模拟。它还强调了在代理系统中使用 LLM 的挑战和限制。太棒了!我们可以看到通过使用 load_summarize_chain 来重新产生之前的结果。
深入了解
- 您可以轻松自定义提示。
- 您可以通过
llm参数轻松尝试不同的 LLM(例如,Claude (opens in a new tab))。
第二选项。Map-Reduce
让我们来解析映射减少的方法。首先,我们将使用 LLMChain 将每个文档映射到单独的摘要。然后,我们使用 ReduceDocumentsChain 将这些摘要合并为一个全局摘要。
首先,我们指定用于将每个文档映射到单独摘要的 LLMChain:
from langchain.chains import MapReduceDocumentsChain, ReduceDocumentsChain
from langchain_text_splitters import CharacterTextSplitter

llm = ChatOpenAI(temperature=0)

# 地图
map_template = """下面是一系列的文档
{docs}
根据这些文档,请确定主要主题
有帮助的答案:"""
map_prompt = PromptTemplate.from_template(map_template)
map_chain = LLMChain(llm=llm, prompt=map_prompt)
我们还可以使用 Prompt Hub 来存储和获取提示。
这将与您的 LangSmith API 密钥 (opens in a new tab) 一起使用。
例如,查看地图提示 here (opens in a new tab)。
from langchain import hub

map_prompt = hub.pull("rlm/map-prompt")
map_chain = LLMChain(llm=llm, prompt=map_prompt)
ReduceDocumentsChain 处理文档映射结果并将其缩减为单个输出。它包装了一个通用的 CombineDocumentsChain(比如 StuffDocumentsChain),但是增加了如果文档的累积大小超过 token_max 时将文档折叠后传递给 CombineDocumentsChain 的能力。在这个例子中,我们实际上可以重复使用我们用于合并文档的链条来折叠文档。
因此,如果映射文档中的累积标记数超过 4000 个标记,那么我们将以小于 4000 个标记的批次递归地将文档传递给我们的 StuffDocumentsChain 以创建批次摘要。一旦这些批次摘要在累积上少于 4000 个标记,我们将最后一次将它们全部传递给 StuffDocumentsChain 以创建最终摘要。
# 缩减
reduce_template = """以下是一些摘要:
{docs}
将它们提取出来,形成一个最终的、综合的主题摘要。
有帮助的答案:"""
reduce_prompt = PromptTemplate.from_template(reduce_template)
# 注意,我们也可以从提示中心获取此信息,如上所述
reduce_prompt = hub.pull("rlm/map-prompt")reduce_prompt(ChatPromptTemplate(input_variables=['docs'], messages=[HumanMessagePromptTemplate(prompt=PromptTemplate(input_variables=['docs'], template='以下是一系列的文档:\n{docs}\n根据这些文档,请确定主要主题\n有帮助的答案:'))]),)# 运行链条
reduce_chain = LLMChain(llm=llm, prompt=reduce_prompt)
# 获取多个文档并将它们合并为单个字符串,然后将其传递给 LLMChain
combine_documents_chain = StuffDocumentsChain(
llm_chain=reduce_chain, document_variable_name="docs"
)
# 合并并迭代地将映射文档缩减
reduce_documents_chain = ReduceDocumentsChain(
# 这是被调用的最终链。
combine_documents_chain=combine_documents_chain,
# 如果文档超出了 `StuffDocumentsChain` 的上下文
collapse_documents_chain=combine_documents_chain,
# 将文档分组的最大标记数。
token_max=4000,
)将我们的地图和缩减链条合并为一个链条:
# 通过映射链条将文档合并,然后合并结果
map_reduce_chain = MapReduceDocumentsChain(
    # 映射链条
    llm_chain=map_chain,
    # 缩减链条
    reduce_documents_chain=reduce_documents_chain,
    # 将文档放入 llm_chain 的变量名
    document_variable_name="docs",
    # 在输出中返回映射步骤的结果
    return_intermediate_steps=False,
)

text_splitter = CharacterTextSplitter.from_tiktoken_encoder(
    chunk_size=1000, chunk_overlap=0
)
split_docs = text_splitter.split_documents(docs)
创建了一个大小为 1003 的块,它比指定的 1000 要长。
print(map_reduce_chain.run(split_docs))根据提供的文档列表,可以确定以下主题:
-
LLM 驱动的自主代理:文档讨论了使用 LLM 作为核心控制器构建代理的概念,并强调了 LLM 在生成书面内容以外的潜力。它们探讨了 LLM 作为一种通用问题解决器的能力。
-
代理系统概述:文档对构成 LLM 驱动的自主代理系统的组件进行了概述,包括规划、记忆和工具使用。详细说明了每个组件的作用,突出了其在增强代理能力方面的作用。
-
规划:文档讨论了代理如何将大型任务分解为较小的子目标,并利用自我反思来提高其行动和结果的质量。
-
记忆:文档解释了短期和长期记忆在代理系统中的重要性。短期记忆用于上下文学习,而长期记忆允许代理在较长时间内保留和回忆信息。
-
工具使用:文档强调了代理使用外部 API 调用附加信息和资源的能力,这些信息和资源在其预训练模型权重中可能缺失。这包括访问当前信息、执行代码和检索专有信息。
-
案例研究和概念验证示例:文档提供了 LLM 驱动的自主代理在科学发现和生成代理模拟等各个领域应用的示例。这些案例研究作为此类代理的能力和潜在应用的示例。
-
挑战:文档承认了建立和利用 LLM 驱动的自主代理所面临的挑战,尽管在给定的文档集中没有提及具体的挑战。
-
引文和参考文献:文档包括引文和参考文献部分,表明所呈现的信息基于现有的研究和来源。
总的来说,提供的文档中的主要主题围绕着 LLM 驱动的自主代理、其组件和能力、规划、记忆、工具使用、案例研究和挑战。
深入理解
自定义
- 如上所示,您可以定制映射和缩减阶段的 LLM 和提示。
实际应用案例
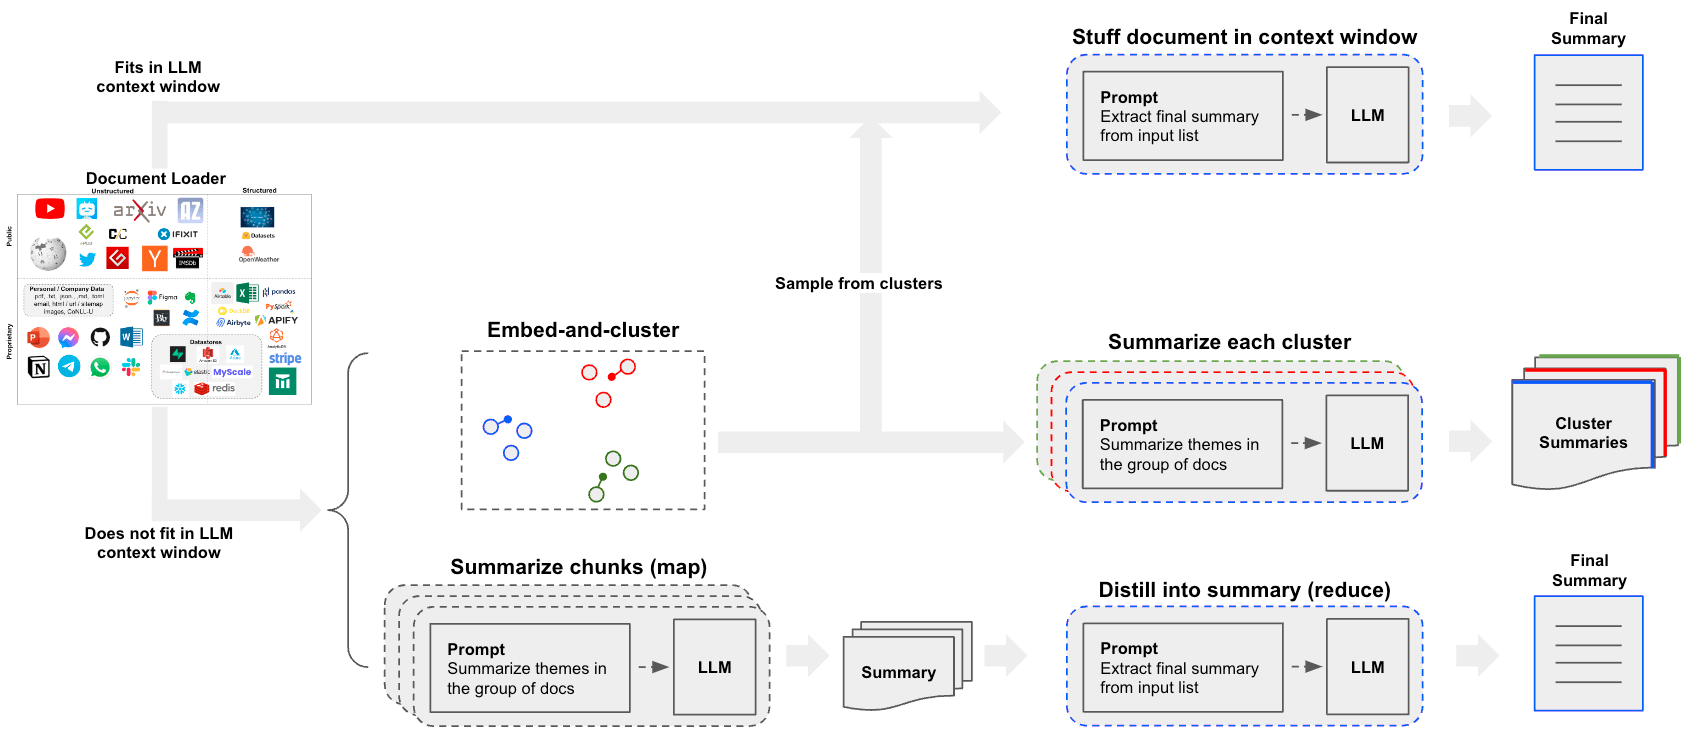
- 请参阅 此博文 (opens in a new tab) 上关于分析用户交互(关于 LangChain 文档的问题)的案例研究!
- 博文和相关的 repo (opens in a new tab) 还介绍了聚类作为总结的手段。
- 这打开了第三条路径,超出了
stuff或map-reduce等方法,值得考虑。
选择 3. 细化
RefineDocumentsChain 类似于 map-reduce:
refine documents chain 通过循环遍历输入文档并迭代更新其答案来构建响应。对于每个文档,它将所有非文档输入、当前文档和最新的中间答案传递给 LLM 链条,以获得新的答案。
这可以通过指定 chain_type="refine" 轻松运行。
chain = load_summarize_chain(llm, chain_type="refine")
chain.run(split_docs)
也可以提供提示并返回中间步骤。
prompt_template = """写一篇简明扼要的摘要:
{text}
简洁摘要:"""
prompt = PromptTemplate.from_template(prompt_template)

refine_template = (
    "您的任务是生成一个最终的摘要\n"
    "我们提供了一个到一定程度的现有摘要: {existing_answer}\n"
    "我们有机会通过下面的一些更多上下文"
    "完善现有的摘要(如果需要的话)。\n"
    "------------\n"
    "{text}\n"
    "------------\n"
    "根据新的上下文,用意大利语完善原始摘要"
    "如果上下文无效,请返回原始摘要。"
)
refine_prompt = PromptTemplate.from_template(refine_template)
chain = load_summarize_chain(
    llm=llm,
    chain_type="refine",
    question_prompt=prompt,
    refine_prompt=refine_prompt,
    return_intermediate_steps=True,
    input_key="input_documents",
    output_key="output_text",
)
result = chain({"input_documents": split_docs}, return_only_outputs=True)print(result["output_text"])文章探讨了使用 LLM(大型语言模型)作为核心控制器构建自主代理的概念。它讨论了任务分解的不同方法,将自我反思整合到基于 LLM 的代理中以及使用外部经典计划器进行长期规划的方法。新的上下文引入了 Chain of Hindsight(CoH)方法和算法蒸馏(AD)以训练模型产生更好的输出。还讨论了不同类型的记忆和使用外部内存进行快速检索的方法。文章探索了工具使用的概念,并引入了 MRKL 系统和通过微调 LLM 使用外部工具的实验。还讨论了在真实场景中使用 LLM 驱动的代理面临的挑战。文章以科学发现代理和 LLM 驱动的代理在抗癌药物发现中的应用案例结束。还引入了结合 LLM、记忆、规划和反思机制的生成型代理的概念。所提供的对话样本讨论了游戏架构的实现以及构建以 LLM 为中心的代理所面临的挑战。文章提供了相关研究论文的引文和参考资源,以供进一步探索。
print("\n\n".join(result["intermediate_steps"][:3]))本文讨论了使用 LLM(大型语言模型)作为核心控制器构建自主代理的概念。文章探索了 LLM 驱动的代理系统的不同组件,包括规划、记忆和工具使用。还提供了 Proof-of-Concept 演示的示例,并强调了 LLM 作为通用问题解决器的潜力。
此文章讨论了使用 LLM(大型语言模型)作为核心控制器构建自主代理的概念。文章探索了 LLM 驱动的代理系统的不同组件,包括规划、记忆和工具使用。还提供了 Proof-of-Concept 演示的示例,并强调了 LLM 作为通用问题解决器的潜力。新的上下文涉及到 Chain of Hindsight(CoH)方法,该方法通过监督学习过程使模型自身改进输出。还介绍了 Algorithm Distillation(AD)方法,该方法将相同的概念应用于强化学习任务的学习轨迹。
此文章讨论了使用 LLM(大型语言模型)作为核心控制器构建自主代理的概念。文章探索了 LLM 驱动的代理系统的不同组件,包括规划、记忆和工具使用。还提供了 Proof-of-Concept 演示的示例,并强调了 LLM 作为通用问题解决器的潜力。新的上下文涉及到 Chain of Hindsight(CoH)方法,该方法通过监督学习过程使模型自身改进输出。还介绍了 Algorithm Distillation(AD)方法,该方法将相同的概念应用于强化学习任务的学习轨迹。==== ===
在一个链中同时拆分和总结
为了方便起见,我们可以将长文档的文本拆分和摘要汇总在一个 AnalyzeDocumentsChain 中。
from langchain.chains import AnalyzeDocumentChain

summarize_document_chain = AnalyzeDocumentChain(
    combine_docs_chain=chain, text_splitter=text_splitter
)
summarize_document_chain.run(docs[0].page_content)