Model I/O
任何语言模型应用的核心要素都是……模型。LangChain 为你提供了与任何语言模型交互的构建模块。
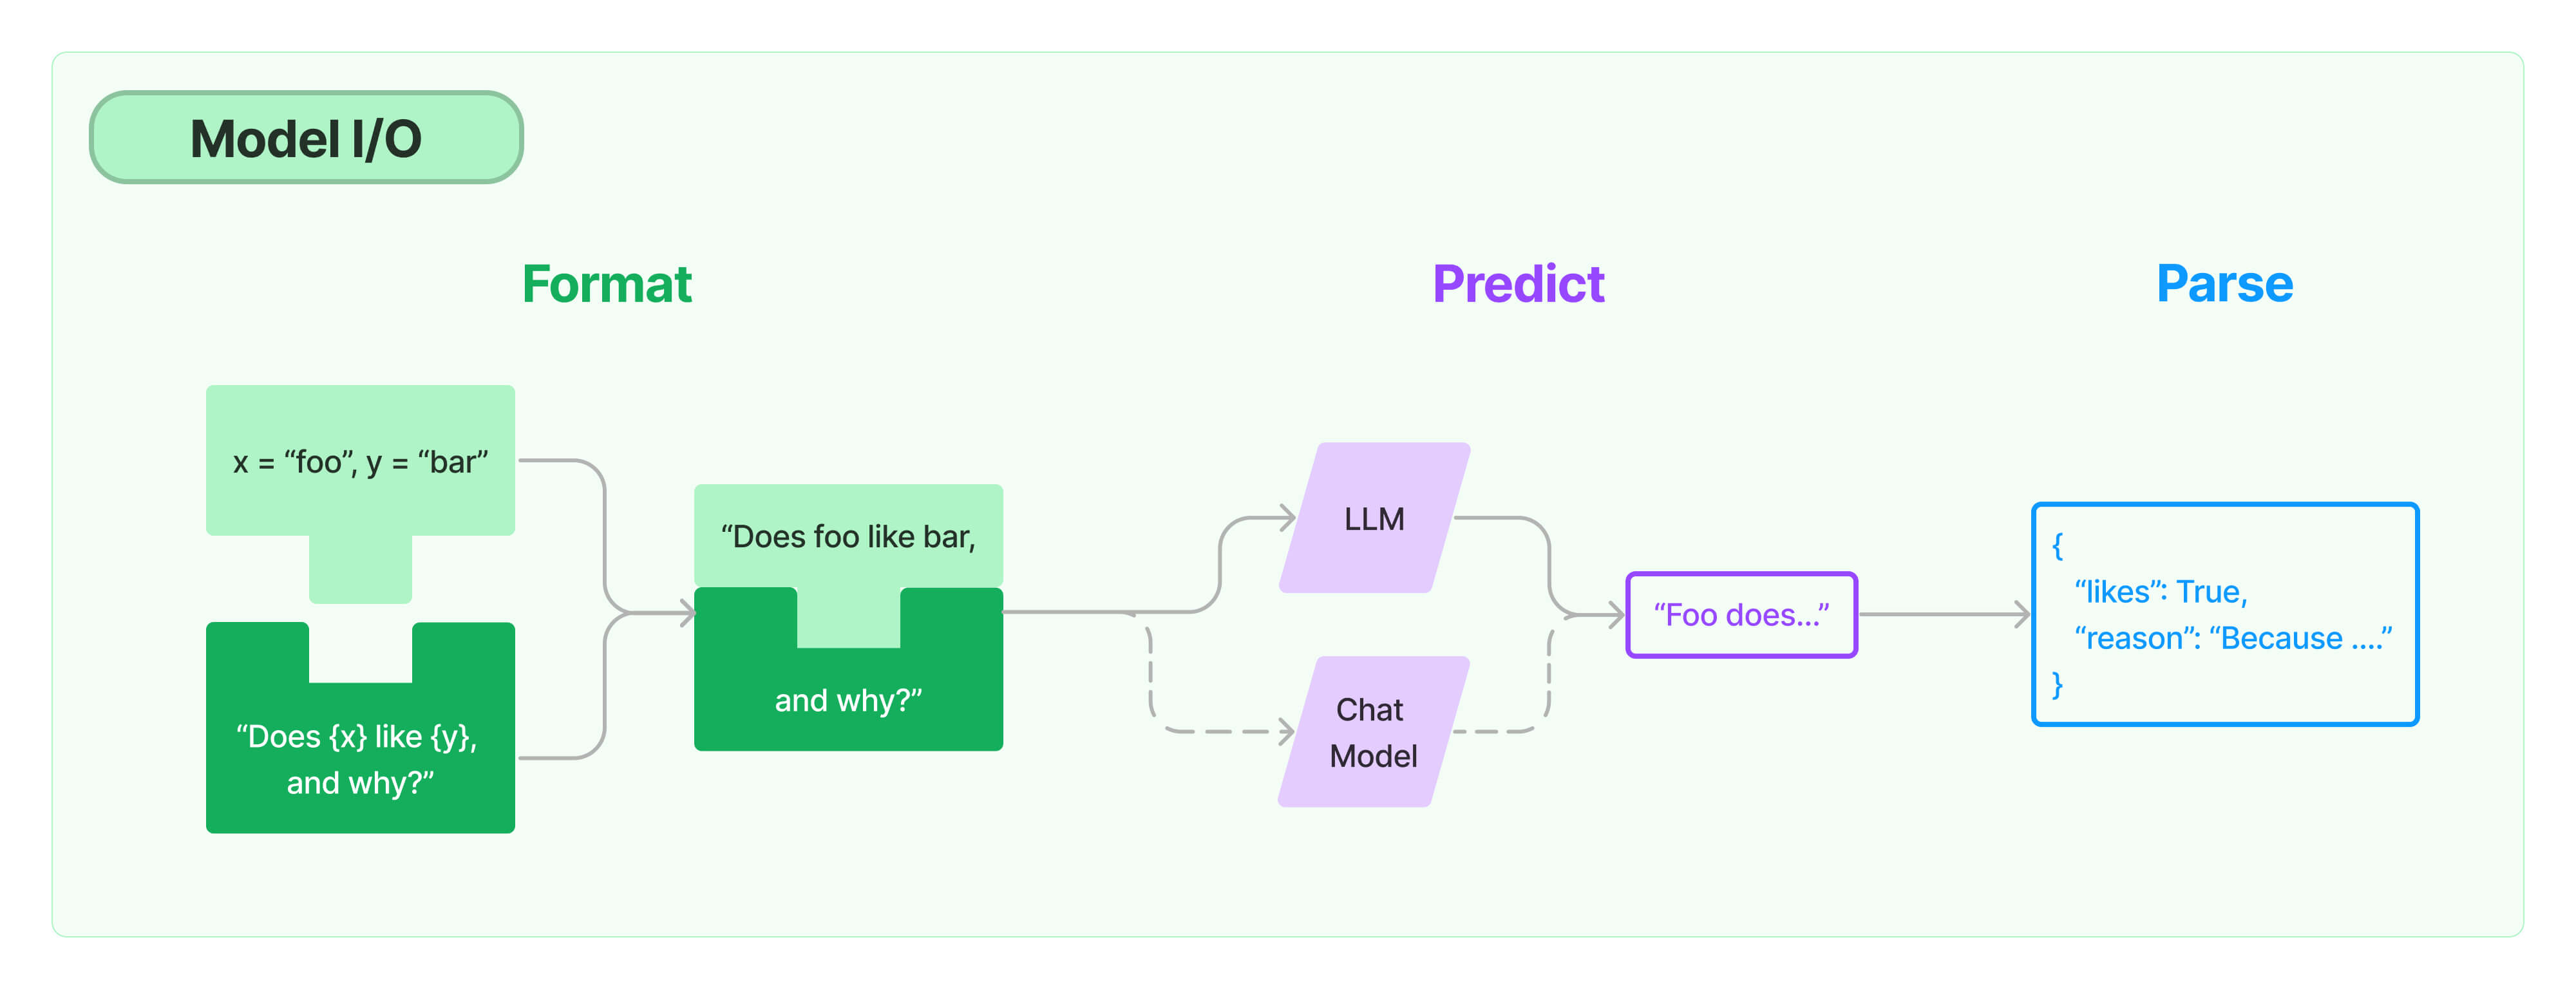
快速入门
以下快速入门将介绍使用 LangChain Model I/O 组件的基础知识。它会先介绍两种不同类型的模型——LLM 和聊天模型(Chat Model),然后介绍如何使用提示模板(Prompt Template)来格式化这些模型的输入,以及如何使用输出解析器(Output Parser)来处理输出。
LangChain 中的语言模型有两种形式:
聊天模型(ChatModels)
聊天模型 通常由 LLM 支撑,但专门针对对话进行了调优。关键在于,它们的提供方 API 使用的是与纯文本补全模型不同的接口。它们不是接收单个字符串,而是接收一组聊天消息作为输入,并返回一条 AI 消息作为输出。有关消息具体由什么构成,请参阅下文。GPT-4 和 Anthropic 的 Claude-2 都是作为聊天模型实现的。
LLMs
LangChain 中的 LLM 指的是纯文本补全模型。它们封装的 API 接收一个字符串提示作为输入,并输出一个字符串补全。OpenAI 的 GPT-3 就是作为 LLM 实现的。
这两种 API 类型具有不同的输入和输出模式。
此外,并非所有模型都是一样的。不同的模型有各自最适合的提示策略。例如,Anthropic 的模型最适合 XML,而 OpenAI 的模型最适合 JSON。在设计应用时,你应该牢记这一点。
在本入门指南中,我们将使用聊天模型,并会提供几个选项:使用 Anthropic 或 OpenAI 之类的 API,或通过 Ollama 使用本地开源模型。
import Tabs from '@theme/Tabs'; import TabItem from '@theme/TabItem'; import CodeBlock from "@theme/CodeBlock";
首先,我们需要安装它们的配套包:
pip install langchain-openai访问 API 需要一个 API 密钥,你可以通过创建账户并前往 此处 (opens in a new tab) 获取。拿到密钥后,我们想通过运行以下命令将其设置为环境变量:
export OPENAI_API_KEY="..."然后我们可以初始化模型:
from langchain_openai import ChatOpenAI
from langchain_openai import OpenAI

llm = OpenAI()
chat_model = ChatOpenAI(model="gpt-3.5-turbo-0125")
如果你不想设置环境变量,可以在初始化 OpenAI LLM 类时通过 api_key 命名参数直接传入密钥:
from langchain_openai import ChatOpenAI
llm = ChatOpenAI(api_key="...")
llm 和 chat_model 都是表示特定模型配置的对象。你可以用 temperature 等参数初始化它们,并在各处传递。
它们的主要区别在于输入和输出模式。
LLM 对象接收字符串作为输入并输出字符串。
ChatModel 对象接收消息列表作为输入并输出一条消息。
在调用时,我们可以看到 LLM 和 ChatModel 之间的区别。
from langchain_core.messages import HumanMessage

text = "What would be a good company name for a company that makes colorful socks?"
messages = [HumanMessage(content=text)]

llm.invoke(text)
# >> Feetful of Fun

chat_model.invoke(messages)
# >> AIMessage(content = "Socks O'Color")
LLM 返回一个字符串,而 ChatModel 返回一条消息。
Ollama (opens in a new tab) 允许你在本地运行开源大语言模型,例如 Llama 2。
首先,按照 这些说明 (opens in a new tab) 设置并运行本地 Ollama 实例:
- 下载 (opens in a new tab)
- 通过
ollama pull llama2拉取模型
然后,确保 Ollama 服务器正在运行。之后,你可以这样做:
from langchain_community.llms import Ollama
from langchain_community.chat_models import ChatOllama

llm = Ollama(model="llama2")
chat_model = ChatOllama()
llm 和 chat_model 都是表示特定模型配置的对象。你可以用 temperature 等参数初始化它们,并在各处传递。
它们的主要区别在于输入和输出模式。
LLM 对象接收字符串作为输入并输出字符串。
ChatModel 对象接收消息列表作为输入并输出一条消息。
在调用时,我们可以看到 LLM 和 ChatModel 之间的区别。
from langchain_core.messages import HumanMessage

text = "What would be a good company name for a company that makes colorful socks?"
messages = [HumanMessage(content=text)]

llm.invoke(text)
# >> Feetful of Fun

chat_model.invoke(messages)
# >> AIMessage(content = "Socks O'Color")
LLM 返回一个字符串,而 ChatModel 返回一条消息。
首先,我们需要导入 LangChain x Anthropic 包。
pip install langchain-anthropic访问 API 需要一个 API 密钥,你可以通过 此处 (opens in a new tab) 创建账户获取。拿到密钥后,我们想通过运行以下命令将其设置为环境变量:
export ANTHROPIC_API_KEY="..."然后我们可以初始化模型:
from langchain_anthropic import ChatAnthropic

chat_model = ChatAnthropic(model="claude-3-sonnet-20240229", temperature=0.2, max_tokens=1024)
如果你不想设置环境变量,可以在初始化 Anthropic Chat Model 类时通过 api_key 命名参数直接传入密钥:
chat_model = ChatAnthropic(api_key="...")首先,我们需要安装它们的配套包:
pip install langchain-cohere访问 API 需要一个 API 密钥,你可以通过创建账户并前往 此处 (opens in a new tab) 获取。拿到密钥后,我们想通过运行以下命令将其设置为环境变量:
export COHERE_API_KEY="..."然后我们可以初始化模型:
from langchain_cohere import ChatCohere

chat_model = ChatCohere()
如果你不想设置环境变量,可以在初始化 Cohere LLM 类时通过 cohere_api_key 命名参数直接传入密钥:
from langchain_cohere import ChatCohere

chat_model = ChatCohere(cohere_api_key="...")
提示模板
大多数 LLM 应用不会把用户输入直接传给 LLM。通常它们会把用户输入加入一段更大的文本中,称为提示模板,用来为手头的特定任务提供额外的上下文。
在上一个示例中,我们传给模型的文本包含了生成公司名称的指令。对于我们的应用来说,如果用户只需提供公司/产品的描述,而无需操心给模型下达指令,那就太好了。
提示模板正是为此而生! 它们把从用户输入到完整格式化提示的所有逻辑都打包在一起。 这可以从非常简单开始——例如,生成上述字符串的提示就只是:
from langchain_core.prompts import PromptTemplate

prompt = PromptTemplate.from_template("What is a good name for a company that makes {product}?")
prompt.format(product="colorful socks")
What is a good name for a company that makes colorful socks?与原始字符串格式化相比,使用它们有几个优势。 你可以把变量“部分(partial)”出来——例如,你可以一次只格式化部分变量。 你可以把它们组合在一起,轻松地将不同的模板合并成一个提示。 关于这些功能的说明,请参阅 提示部分 了解更多细节。
PromptTemplate 还可以用来生成消息列表。
在这种情况下,提示不仅包含内容信息,还包含每条消息的信息(它的角色、在列表中的位置等)。
这里最常见的情况是,ChatPromptTemplate 是一个 ChatMessageTemplate 列表。
每个 ChatMessageTemplate 都包含如何格式化该 ChatMessage 的说明——它的角色以及它的内容。
让我们在下面看一下:
from langchain_core.prompts.chat import ChatPromptTemplate

template = "You are a helpful assistant that translates {input_language} to {output_language}."
human_template = "{text}"

chat_prompt = ChatPromptTemplate.from_messages([
    ("system", template),
    ("human", human_template),
])

chat_prompt.format_messages(input_language="English", output_language="French", text="I love programming.")
[
SystemMessage(content="You are a helpful assistant that translates English to French.", additional_kwargs={}),
HumanMessage(content="I love programming.")
]ChatPromptTemplate 还可以用其他方式构建——更多细节请参阅 提示部分。
输出解析器
OutputParser 将语言模型的原始输出转换为可供下游使用的格式。
OutputParser 有几种主要类型,包括:
- 将
LLM的文本转换为结构化信息(例如 JSON) - 将
ChatMessage转换为一个字符串 - 将调用返回的除消息之外的额外信息(如 OpenAI 函数调用)转换为字符串。
关于此的完整信息,请参阅 输出解析器部分。
在本入门指南中,我们使用一个简单的解析器,它解析逗号分隔的值列表。
from langchain.output_parsers import CommaSeparatedListOutputParser

output_parser = CommaSeparatedListOutputParser()
output_parser.parse("hi, bye")
# >> ['hi', 'bye']
使用 LCEL 组合
我们现在可以把所有这些组合成一个链。 这个链将接收输入变量,把它们传给提示模板以创建提示,将提示传给语言模型,然后将输出通过一个(可选的)输出解析器。 这是打包一段模块化逻辑的便捷方式。 让我们看看它的实际效果!
template = "Generate a list of 5 {text}.\n\n{format_instructions}"

chat_prompt = ChatPromptTemplate.from_template(template)
chat_prompt = chat_prompt.partial(format_instructions=output_parser.get_format_instructions())
chain = chat_prompt | chat_model | output_parser
chain.invoke({"text": "colors"})
# >> ['red', 'blue', 'green', 'yellow', 'orange']
请注意,我们使用 | 语法将这些组件连接在一起。
这个 | 语法由 LangChain 表达式语言(LCEL)驱动,依赖于所有这些对象都实现的通用 Runnable 接口。
要了解更多关于 LCEL 的信息,请阅读 此处 的文档。
结论
以上就是提示、模型和输出解析器的入门介绍!这仅仅涵盖了可学习内容的皮毛。如需更多信息,请查看:
- 提示部分,了解如何使用提示模板
- ChatModel 部分,了解 ChatModel 接口的更多信息
- LLM 部分,了解 LLM 接口的更多信息
- 输出解析器部分,了解不同类型的输出解析器。